
NVIDIA Sweeps MLPerf Training and Endpoints as Vera Rubin Debuts With Leading Performance
Na estreia de Vera Rubin em MLPerf Endpoints e Training v6.1, a plataforma varreu benchmarks de treino e mostrou mais de 10x ganho geracional em throughput por watt para agentic AI.
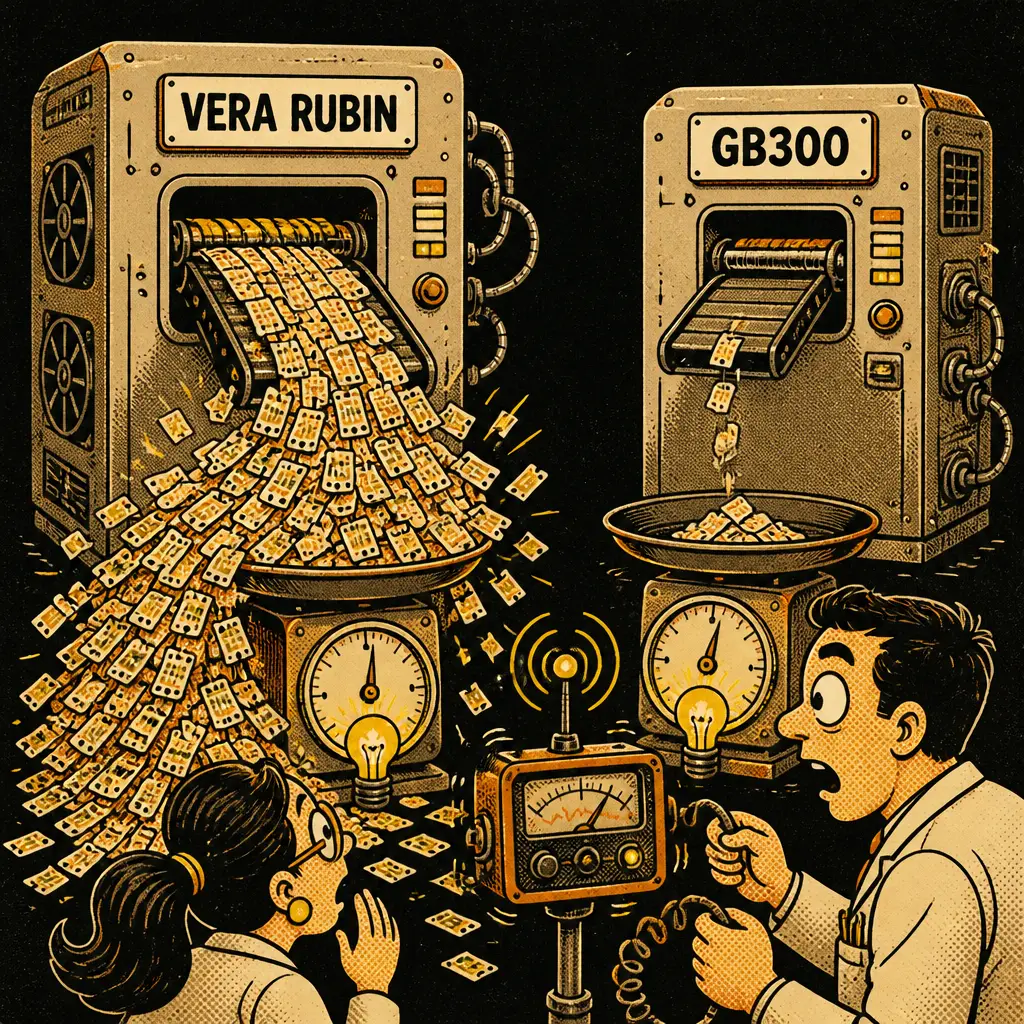
A NVIDIA estreou a plataforma Vera Rubin (NVL72) em MLPerf Training v6.1 e varreu todos os benchmarks da rodada; em alguns casos o NVL72 entregou até 2x mais performance por GPU que o sistema GB300 NVL72. Na primeira submissão a MLPerf® Endpoints v1.0, Vera Rubin NVL72 mostrou mais de 10x de throughput por watt em cargas agentic (Kimi K3) na comparação com GB300 NVL72, medindo resultados a um mínimo compartilhado de 50 tokens/sec por usuário. Em escala, Vera Rubin NVL72 manteve cerca de 97% de eficiência ao escalar DeepSeek-V3 de 256 para 1,024 GPUs; GB300 e Microsoft Azure também rodaram testes em 10,240 GPUs nesta rodada.
Por que importa: isso muda trade-offs de capacity planning e eficiência energética para workloads agentic e treinamento em larga escala. O que fazer: reavalie escolhas de hardware e orçamento com testes próprios (MLPerf ou medições de throughput por watt) nas suas cargas agentic, valide E2E interactivity alvo e verifique comportamento ao escalar para milhares de GPUs antes de decidir deploys.
Quadrinho 1 de 2
- #benchmarks
- #agentic-ai