
Run Native DLA Inference in Python on NVIDIA Jetson AGX Orin Using cuDLA
NVIDIA publicou um guia para rodar inferência nativa no Deep Learning Accelerator (DLA) em Python no Jetson AGX Orin usando a biblioteca cuDLA.
A NVIDIA publicou um guia mostrando como rodar inferência DLA nativa em Python no Jetson AGX Orin usando a camada cuDLA exposta pelo pacote cuda-bindings (introduzido em cuda-bindings 13.3.0). O post descreve um ciclo de inferência em nove etapas — inicializar CUDA, criar um dispositivo DLA em modo híbrido, carregar um loadable compilado, introspectar descritores de tensor, alocar buffers GPU, registrá‑los para DLA, copiar entradas pré‑processadas, submeter a tarefa numa CUDA stream e sincronizar para ler resultados — e explica que JetPack (a partir da versão mencionada) fornece libcudla.so no dispositivo. O exemplo de compilação usa TensorRT 11.4.1 com CUDA 13.4 Update 1 em JetPack 7.2.2 e recomenda pip install "cuda-bindings>=13.3.0"; o mínimo de Python é 3.10 (o texto mostra como instalar Python 3.12 se preciso). Nem todas as camadas são compatíveis com DLA; prepare pipeline para compilar loadables, ajustar o ONNX quando necessário e tratar erros (por exemplo, create_device pode lançar CudlaError(ErrorUnsupportedOperation)).
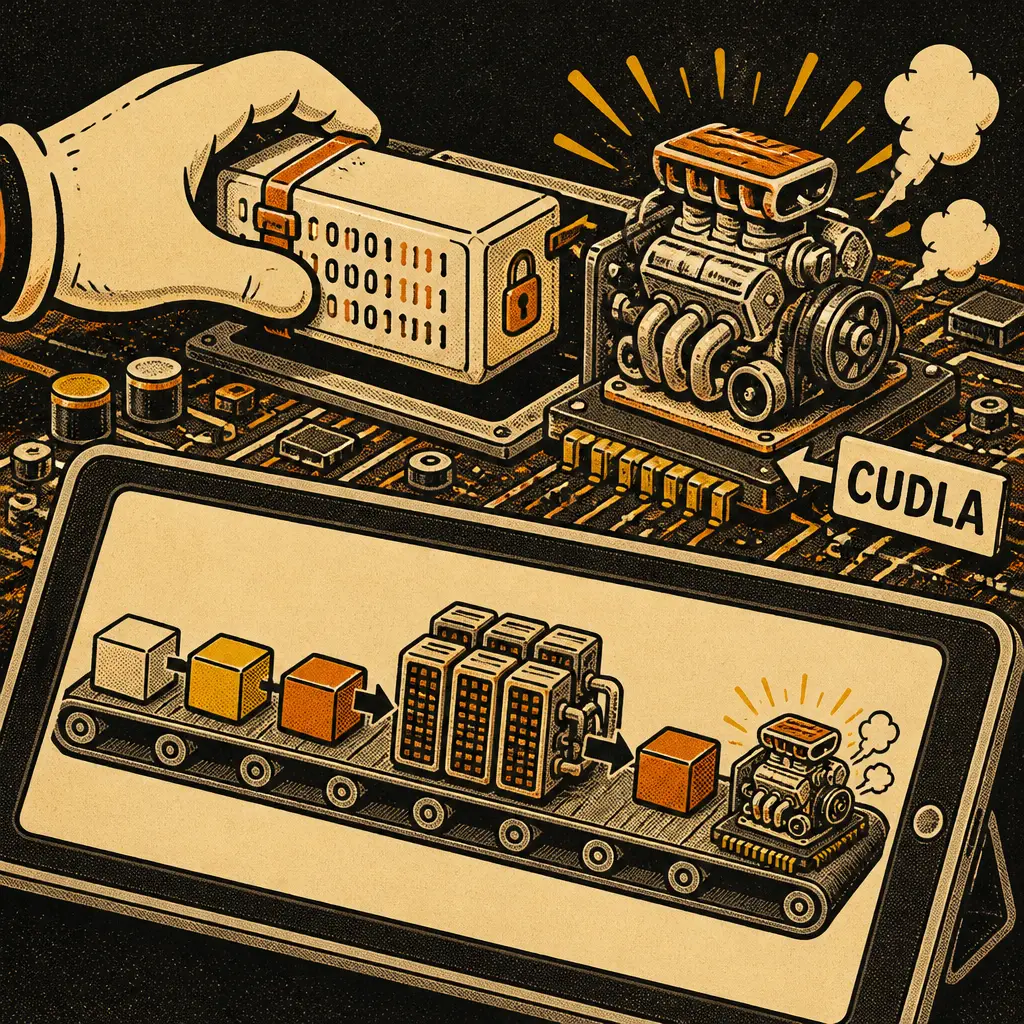
Quadrinho 1 de 3
- #jetson
- #cuda
- #dla
- #embedded