
When One GPU Isn’t Enough: Serving GLM-5.3 Across Two NVIDIA DGX Stations with vLLM
Nvidia mostra como executar GLM-5.3 mantendo todos os pesos na memória GPU e servindo o modelo distribuído com vLLM across duas DGX Stations, quando um único GPU não é suficiente.
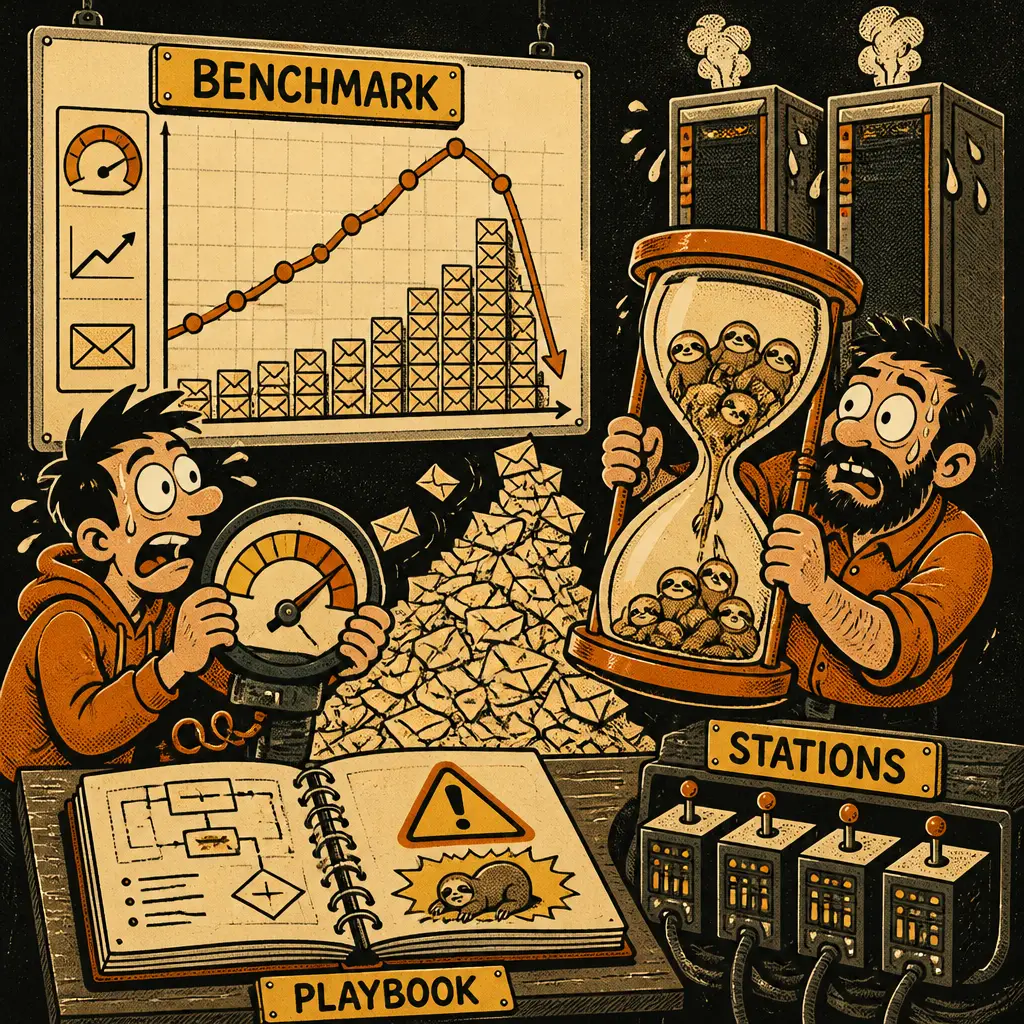
A NVIDIA detalha como servir GLM-5.3 NVFP4 — um MoE com 753 billion parameters e ~40 billion ativados por token — mantendo todos os pesos em GPU: o checkpoint ocupa ~464 GB, acima dos 252 GB de HBM3e de um único GB300, então duas NVIDIA DGX Stations conectadas por ConnectX‑8 RDMA usam tensor parallelism (TP=2) e vLLM para distribuir inferência, com suporte a multi-token prediction, FP8 KV-cache e prefix caching. Em AIPerf o throughput atingiu 607.8 tokens/s a concorrência 16 e caiu para 385.0 tokens/s a concorrência 32; latência média reportada foi 453.5 seconds.
Por que importa e o que fazer: quando um GPU não cabe no modelo, engenheiros seniores precisam projetar deploys multi-node dimensionando memória GPU total, link RDMA e validar latência/throughput do vLLM antes da produção. Siga o playbook de conexão das estações e o repositório Local AI para configurações recomendadas, conecte sua aplicação conforme a documentação do vLLM, rode AIPerf com seus prompts para achar a concorrência ideal, e proteja a API com firewall, autenticação e TLS.
Quadrinho 1 de 3
- #benchmarks
- #ai
- #vllm
- #glm-5.3